Texto a voz que corre en CPU. Su modelo KittenTTS 2 habla 20 idiomas, incluido español, y clona voces con 5 a 30 segundos de audio.
¿Es gratis?
El software, sí. Es código abierto con licencia Apache-2.0 (código) + licencia Stellon (modelo): lo descargas y lo usas sin pagar licencia ni suscripción. Ojo con la licencia del modelo: El código es Apache-2.0, pero el modelo KittenTTS 2 usa la Stellon Labs Community License: para uso comercial tienes que registrarte con Stellon Labs, y la licencia gratis se termina si tú o tus empresas afiliadas superan US$1 millón de ingresos al año o US$1 millón de financiación total; desde ahí tienes que pedirles una licencia. Si lo distribuyes, pide atribución. Clona solo tu voz o una con permiso. Lo que puede costarte:
Nada en tu PC.
Uso comercial: registro con Stellon Labs, y licencia aparte si tú o tu empresa superan US$1 millón de ingresos o de financiación.
Estrellas en GitHub
★ 16.495 al 26 oct 2026
Licencia
Apache-2.0 (código) + licencia Stellon (modelo) · Uso comercial: Sí, el programa; lo generado depende del modelo El código es Apache-2.0, pero el modelo KittenTTS 2 usa la Stellon Labs Community License: para uso comercial tienes que registrarte con Stellon Labs, y la licencia gratis se termina si tú o tus empresas afiliadas superan US$1 millón de ingresos al año o US$1 millón de financiación total; desde ahí tienes que pedirles una licencia. Si lo distribuyes, pide atribución. Clona solo tu voz o una con permiso.
Requisitos
GPU opcional Python 3.9 o superior; sin GPU, unos 6 GB de RAM (con GPU CUDA, unos 8 GB libres) y 1 GB de disco para el modelo. En nuestra prueba con CPU y Python, 11,1 s de audio tardaron unos 40 s, más 28–38 s de carga, y el proceso llegó a 6,6 GB de RAM. El README dice que su versión en C++ es la forma más rápida en CPU; esa no la probamos.
Instalamos kittenml con PyTorch para CPU y generamos una frase en español con la voz «Spanish», sin clonar a nadie: 11,1 s de audio en unos 40 s. No probamos la clonación de voz ni la versión en C++.
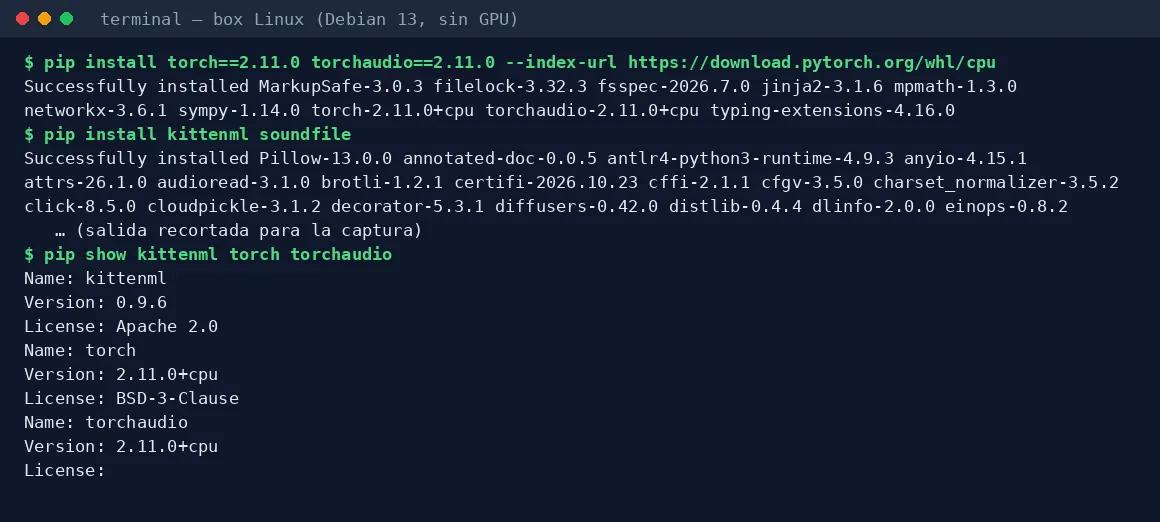
Equipo: Linux (Debian 13), 8 núcleos, 15 GB de RAM, sin GPU · kittenml 0.9.6, PyTorch 2.11 (CPU) · 26 oct 2026
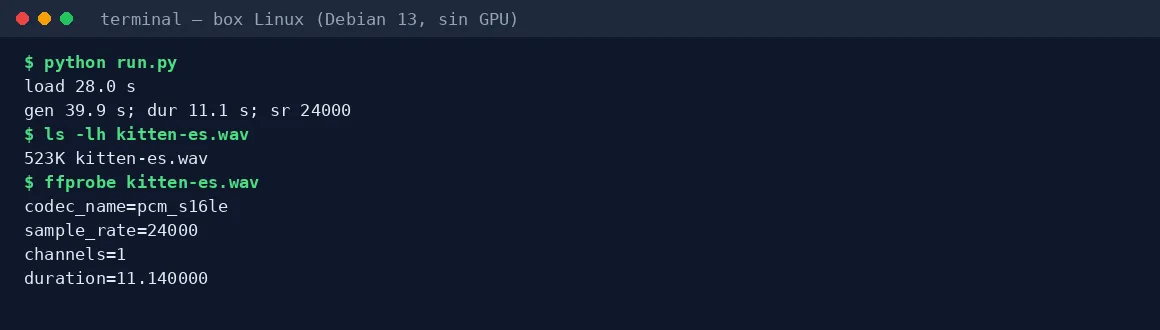
KittenTTS no tiene ventana: se usa desde Python. Esta es la salida real de nuestra prueba, 26 oct 2026. (La captura de la demo en Hugging Face no cargó a tiempo.)
Estrellas y versión de la API de GitHub; requisitos del README oficial. ¿Ves un dato incorrecto? Avísanos.
✓ Probado por IACreadora el 26 oct 2026 en Linux sin GPU
Resultado de nuestra prueba
La voz en español que generó KittenTTS en nuestra prueba, usando solo el procesador.
Este es el audio tal como lo generó KittenTTS 2 en nuestra computadora, sin GPU (lo pasamos de WAV a MP3 para la web):
Texto que le dimos
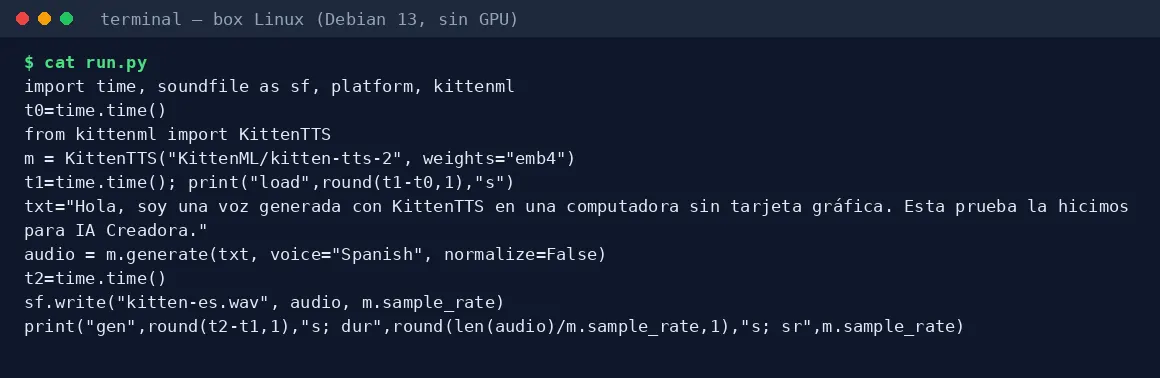
«Hola, soy una voz generada con KittenTTS en una computadora sin tarjeta gráfica. Esta prueba la hicimos para IA Creadora.»
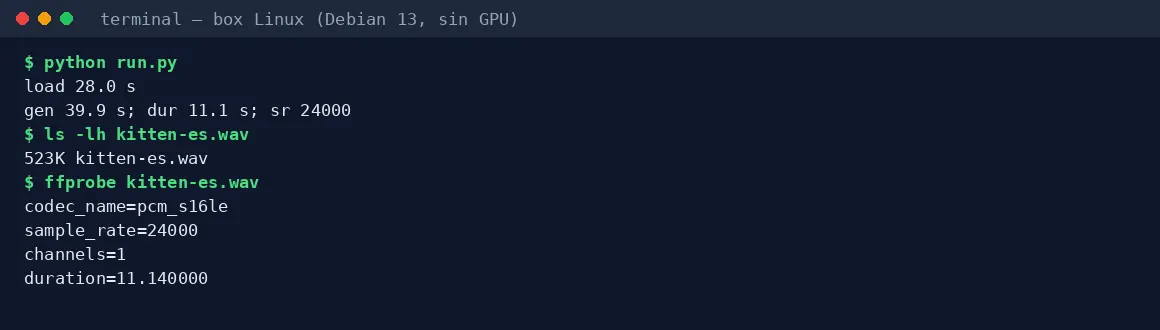
Tiempo: unos 40 s para generar 11,1 s de audio, más 28 a 38 s para cargar el modelo (8 núcleos, sin GPU). El proceso usó hasta 6,6 GB de RAM.
Modelo: kitten-tts-2 con los pesos ligeros «emb4» (506 MiB), paquete kittenml 0.9.6, voz «Spanish», 24 kHz.
Voz: una de las que trae el modelo. No clonamos a nadie.
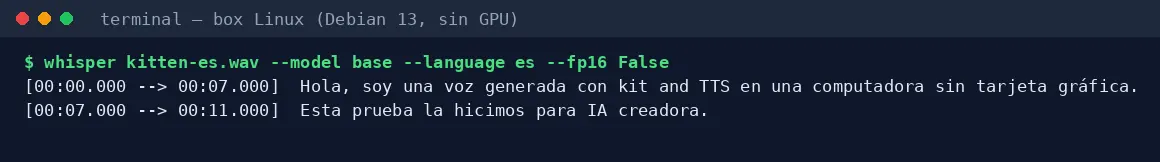
Comprobación: Whisper transcribió el audio palabra por palabra, incluido «Kitten TTS».
Si quieres clonar tu voz, la guía explica cómo, según la documentación. Recuerda: solo tu voz o una con permiso.
Nuestra prueba, paso a paso (5 capturas)
Capturas reales de cada paso, del 26 oct 2026. La guía de instalación las explica una por una.
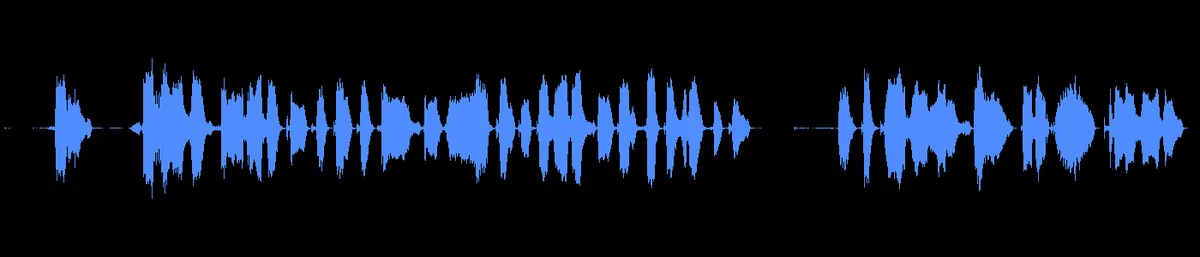
Captura 1. Instalación en un entorno limpio: primero PyTorch 2.11 para CPU y luego kittenml 0.9.6.Captura 2. El script de prueba: voz «Spanish» y normalize=False, como pide la documentación para texto que no es inglés.Captura 3. Generación: el modelo cargó en 28 s (ya descargado) y tardó 40 s en crear 11,1 s de audio, a 24 kHz.Captura 4. Pasamos el audio por Whisper para comprobar que se entiende.Captura 5. Forma de onda del WAV generado (11,1 s).
ElevenLabs suena mejor y tiene app web. KittenTTS es un modelo que corre en tu PC sin GPU, con español y clonación; gratis para creadores pequeños, pero su licencia pide registro para uso comercial.
ElevenLabs: Desde US$6/mes (Starter), facturación mensual · revisado el 14 oct 2026
Speechify lee textos con voces de calidad desde una app. KittenTTS es para quien quiere generar audios en su PC con un script, sin suscripción.
Speechify: Desde US$100/año (Studio Starter, ≈US$8.33/mes), facturación anual · revisado el 14 oct 2026
Preguntas frecuentes
¿KittenTTS es gratis?
Sí: el programa es de código abierto (Apache-2.0 (código) + licencia Stellon (modelo)) y no pagas licencia para uso personal; el uso comercial tiene condiciones (ver licencia). Lo que puede costar: Nada en tu PC. Uso comercial: registro con Stellon Labs, y licencia aparte si tú o tu empresa superan US$1 millón de ingresos o de financiación.
¿KittenTTS necesita tarjeta gráfica?
GPU opcional (corre en CPU). Python 3.9 o superior; sin GPU, unos 6 GB de RAM (con GPU CUDA, unos 8 GB libres) y 1 GB de disco para el modelo. En nuestra prueba con CPU y Python, 11,1 s de audio tardaron unos 40 s, más 28–38 s de carga, y el proceso llegó a 6,6 GB de RAM. El README dice que su versión en C++ es la forma más rápida en CPU; esa no la probamos.
¿Se puede probar KittenTTS sin instalar?
Prueba en el navegador en KittenML Platform, según el README (no la probamos).
¿Puedo usar KittenTTS para contenido comercial?
El código es Apache-2.0, pero el modelo KittenTTS 2 usa la Stellon Labs Community License: para uso comercial tienes que registrarte con Stellon Labs, y la licencia gratis se termina si tú o tus empresas afiliadas superan US$1 millón de ingresos al año o US$1 millón de financiación total; desde ahí tienes que pedirles una licencia. Si lo distribuyes, pide atribución. Clona solo tu voz o una con permiso.
 De pago / freemium
 MoneyPrinterTurbo
 ComfyUI
 Buzz
 Chatterbox
 OpenCut
 Concat