Inicio › Open source › KittenTTS › Cómo instalar
Cómo instalar KittenTTS y generar voz en español
Revisado el 26 oct 2026, versión kittenml 0.9.6 (modelo kitten-tts-2). Probado en Linux (Debian 13), 8 núcleos, 15 GB de RAM, sin GPU. Cada paso indica si lo probamos o si sale de la documentación oficial.
Instala PyTorch para CPU y luego «pip install kittenml». Con un script de 8 líneas generas voz en español con la voz «Spanish». En nuestra prueba sin GPU, 11,1 s de audio tardaron unos 40 s. No tiene app con ventanas. Uso comercial: regístrate con Stellon Labs y ojo con el tope de US$1 millón.
0 Antes de empezar: voces con permiso y licencia
Basado en la documentación oficialUsa solo tu propia voz o una voz con permiso por escrito. Clonar la voz de otra persona sin su consentimiento puede ser ilegal y viola las reglas de TikTok, YouTube e Instagram. Si publicas voz generada que suena real, etiquétala como contenido hecho con IA.
El modelo KittenTTS 2 no es MIT ni Apache: usa la Stellon Labs Community License. Lo explicamos en el paso 8.
1 ¿Tu PC sirve?
Basado en la documentación oficial ✓ Probado por IACreadora en Linux sin GPU- Según el README: Python 3.9 o superior; sin GPU, unos 6 GB de RAM (con GPU CUDA, unos 8 GB libres) y 1 GB de disco para el modelo.
- Lo que medimos: 8 núcleos sin GPU; el proceso llegó a 6,6 GB de RAM y tardó unos 40 s para 11,1 s de audio.
2 Pruébalo sin instalar
Basado en la documentación oficialEl README ofrece una prueba en el navegador en KittenML Platform («Free API») y una demo en Hugging Face. No las probamos: la demo de Hugging Face no terminó de cargar cuando intentamos capturarla.
3 Instalación con pip
✓ Probado por IACreadora en Linux sin GPUSi no tienes NVIDIA, instala primero PyTorch para CPU. En nuestro primer intento, pip pidió una versión de torchaudio (2.14.1) que no existe para CPU; fijar torch y torchaudio 2.11.0 lo resolvió:
python3 -m venv .venv && source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install torch==2.11.0 torchaudio==2.11.0 --index-url https://download.pytorch.org/whl/cpu
pip install kittenml soundfile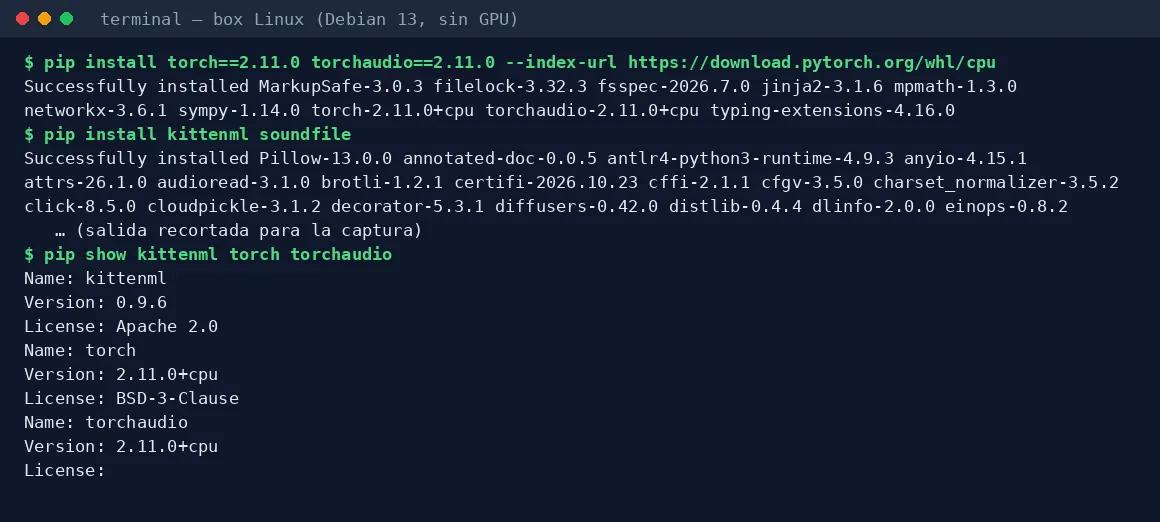
4 Tu primer audio en español
✓ Probado por IACreadora en Linux sin GPUGuarda esto como voz.py y ejecútalo con python voz.py. La primera vez descarga el modelo. Usamos los pesos ligeros «emb4» (506 MiB en vez de 947) y normalize=False, que la documentación recomienda para texto que no es inglés:
import soundfile as sf
from kittenml import KittenTTS

m = KittenTTS("KittenML/kitten-tts-2", weights="emb4")
texto = "Hola, soy una voz generada con KittenTTS en una computadora sin tarjeta gráfica."
audio = m.generate(texto, voice="Spanish", normalize=False)
sf.write("voz.wav", audio, m.sample_rate)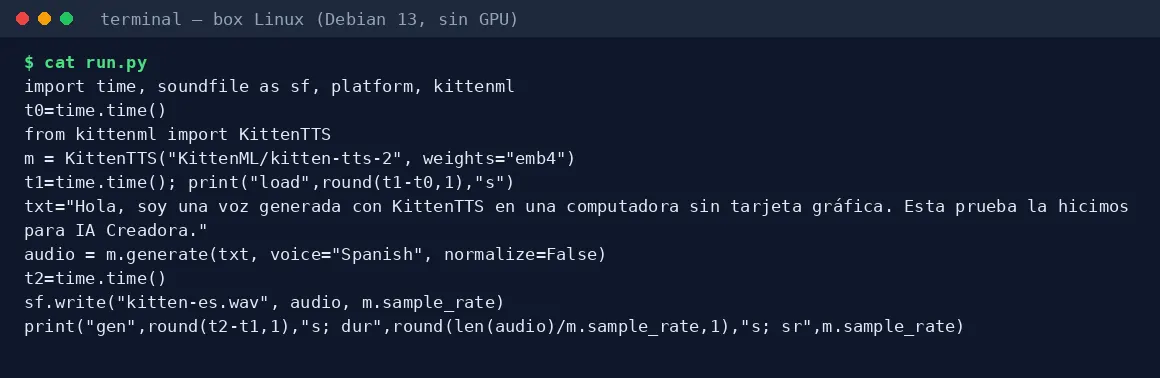
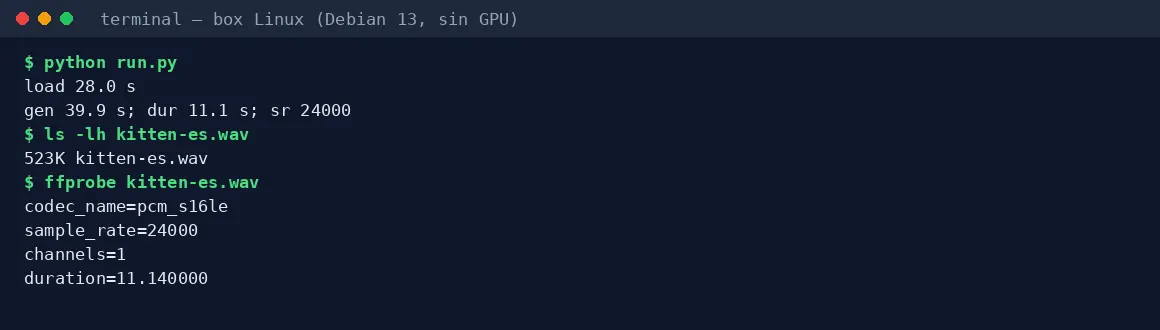
Este es el audio que salió en nuestra prueba:
5 Comprueba que se entiende
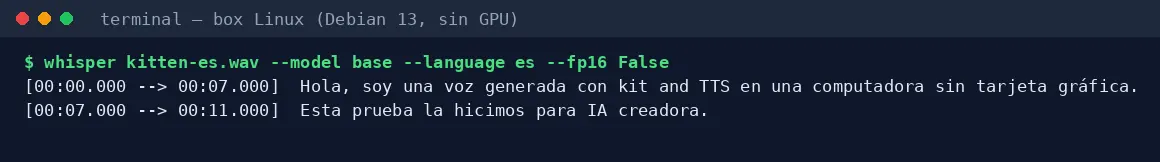
✓ Probado por IACreadora en Linux sin GPUPasamos el audio por Whisper (modelo base). En la primera generación transcribió todo bien, incluido «Kitten TTS»; al repetir la prueba, escribió «kit and TTS»: cada generación sale un poco distinta. El audio de esta página es el de la primera.
6 Clonar tu voz
Basado en la documentación oficialNo lo probamos. Según el README, basta con 5 a 30 segundos de audio, sin entrenar nada: se pasa reference= en lugar de voice=.
audio = m.generate("Esta es mi propia voz.", reference="mi_voz.wav", normalize=False)Solo con tu voz o con permiso por escrito (paso 0).
7 Más rápido en CPU: versión en C++
Basado en la documentación oficialNo lo probamos. El README dice que la forma más rápida de usarlo en CPU es su versión en C++ (un fork de llama.cpp), que también se instala con pip: pip install kitten_tts_cpp.
8 Licencia y uso comercial
Basado en la documentación oficial- El código del paquete tiene licencia Apache-2.0.
- El modelo KittenTTS 2 usa la Stellon Labs Community License: gratis para investigación, uso no comercial y uso comercial limitado.
- Uso comercial: tienes que registrarte con Stellon Labs.
- Tope de US$1 millón: si tú o tus empresas afiliadas superan US$1 millón de ingresos al año, o US$1 millón de financiación total, la licencia gratis termina y tienes que pedirles una licencia.
- Si lo distribuyes en un producto, tienes que incluir la licencia y su aviso de atribución.
Resumen del texto de la licencia del 26 oct 2026; no es asesoría legal.
Ficha de KittenTTS: requisitos y licencia Repositorio en GitHub ↗
Preguntas frecuentes
¿KittenTTS es gratis?
En tu PC, sí, para uso personal y para creadores pequeños. Para uso comercial hay que registrarse con Stellon Labs, y deja de ser gratis si tú o tu empresa superan US$1 millón de ingresos anuales o de financiación.
¿KittenTTS habla español?
Sí. KittenTTS 2 tiene 20 idiomas. Lo probamos con la voz «Spanish» y Whisper lo entendió bien.
¿KittenTTS necesita tarjeta gráfica?
No. Lo probamos solo con CPU: 11,1 s de audio en unos 40 s, con 6,6 GB de RAM.
¿Puedo clonar cualquier voz con KittenTTS?
Técnicamente clona con 5 a 30 s de audio (no lo probamos), pero solo debes clonar tu voz o una con permiso.