Inicio › Open source › Chatterbox › Cómo instalar
Cómo instalar Chatterbox y generar voz en español
Revisado el 19 oct 2026, versión chatterbox-tts 0.1.7. Probado en Linux (Debian 13), 8 núcleos, 15 GB de RAM, sin GPU. Cada paso indica si lo probamos o si sale de la documentación oficial.
Para probar sin instalar, usa la demo oficial en Hugging Face (hay una de español latino). Para tenerlo en tu PC: Python 3.11 y «pip install chatterbox-tts». Funciona sin GPU, pero lento: 5,6 s de audio tardaron 35 s en nuestra prueba con CPU. Clona solo tu voz o una con permiso.
0 Antes de empezar: voces con permiso
Basado en la documentación oficialUsa solo tu propia voz o una voz con permiso por escrito. Clonar la voz de otra persona sin su consentimiento puede ser ilegal y viola las reglas de TikTok, YouTube e Instagram. Chatterbox mete en cada audio una marca de agua inaudible (Perth) que permite detectar que es voz generada.
1 ¿Tu PC sirve?
Basado en la documentación oficial ✓ Probado por IACreadora en Linux sin GPU- GPU: opcional. Con NVIDIA va mucho más rápido; en Mac usa
mps. - Sin GPU: funciona. Lo medimos: 5,6 s de audio en 35 s, más 20 s para cargar el modelo, con 8 núcleos.
- Disco: el entorno con PyTorch para CPU ocupó 1,5 GB y cada modelo multilingüe descarga unos 3,3 GB.
- Python: el proyecto se desarrolló y probó con Python 3.11.
2 Pruébalo sin instalar (gratis)
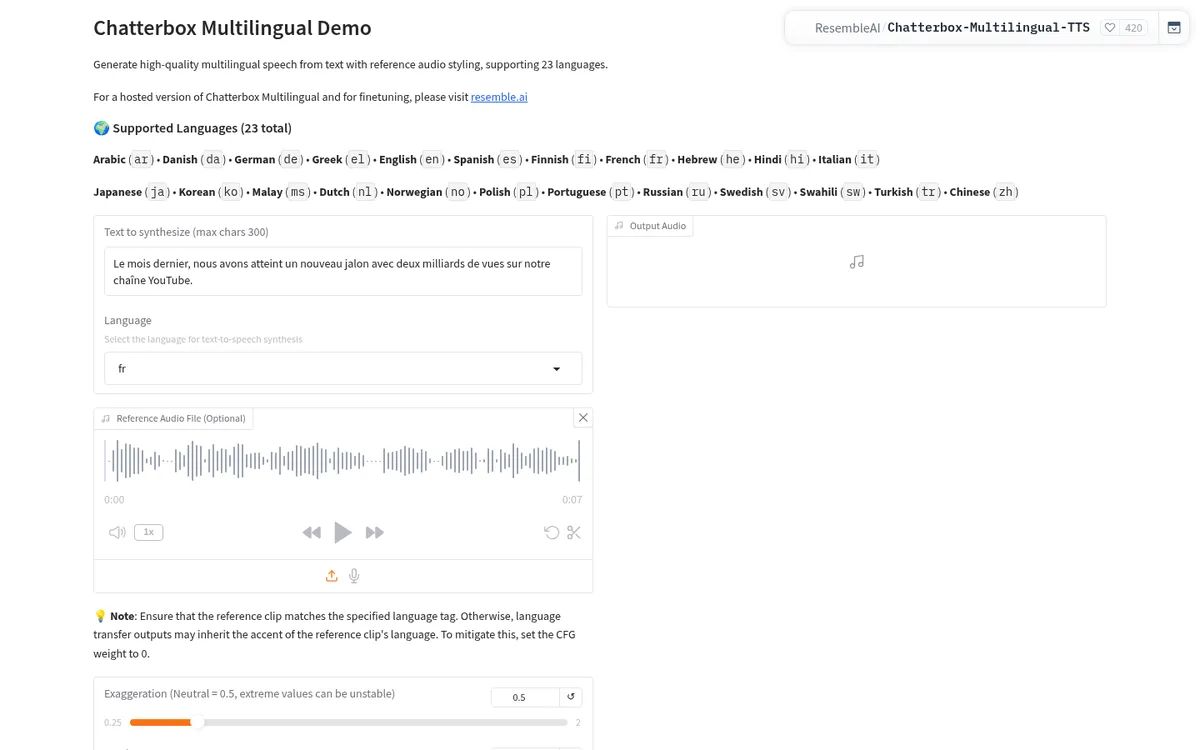
Basado en la documentación oficial- Demo multilingüe (23 idiomas, incluido español).
- Demo de español latino (es-MX/LatAm).
Las dos estaban activas el 19 oct 2026. Corren en ZeroGPU de Hugging Face: son gratis con una cuota diaria de GPU (las cuentas PRO tienen 8 veces más).
3 Instalación con pip
✓ Probado por IACreadora en Linux sin GPUNo hay instalador de un clic: se usa desde Python. Si tu PC no tiene NVIDIA, instala primero PyTorch para CPU y te ahorras varios GB de descarga.
python3.11 -m venv .venv && source .venv/bin/activate   # Windows: .venv\Scripts\activate
# sin GPU NVIDIA:
pip install torch==2.6.0 torchaudio==2.6.0 --index-url https://download.pytorch.org/whl/cpu
pip install chatterbox-tts
pip install "setuptools<81"   # evita el error de pkg_resources (ver abajo)
Así instalamos la versión 0.1.7 de PyPI.
4 Tu primer audio en español
✓ Probado por IACreadora en Linux sin GPUGuarda esto como voz.py y ejecútalo con python voz.py. Usa la voz por defecto, sin clonar a nadie:
import torchaudio as ta
from chatterbox.mtl_tts import ChatterboxMultilingualTTS

modelo = ChatterboxMultilingualTTS.from_pretrained(device="cpu")  # "cuda" con NVIDIA, "mps" en Mac
texto = "Hola, esta es una prueba de voz generada sin tarjeta gráfica."
audio = modelo.generate(texto, language_id="es")
ta.save("voz.wav", audio, modelo.sr)
Este es el audio que salió en nuestra prueba (voz por defecto, CPU):
Para clonar tu voz, graba unos 10 segundos limpios y pasa el archivo con audio_prompt_path="mi_voz.wav" en generate(). El README aconseja que el audio de referencia esté en el mismo idioma que el texto.
Modelo V3 (más nuevo)
El V3 multilingüe todavía no está en el paquete de pip (0.1.7). Para usarlo, instala desde el código del repo y pasa t3_model="v3":
git clone https://github.com/resemble-ai/chatterbox.git
cd chatterbox && pip install -e .
# en el script:
modelo = ChatterboxMultilingualTTS.from_pretrained(device="cpu", t3_model="v3")
Lo probamos: 6,2 s de audio en 37 s con CPU. En nuestra única prueba, al pasarlo por Whisper, el V3 añadió una palabra de más al final; el modelo de pip no. Con una sola frase no da para sacar conclusiones. Los modelos dedicados de español latino y de España están enlazados en el README; esos los probamos solo en la demo.
5 Errores comunes
✓ Probado por IACreadora en Linux sin GPU- «No module named 'pkg_resources'» o «'NoneType' object is not callable» en
PerthImplicitWatermarker. Falta setuptools (la marca de agua lo necesita):pip install "setuptools<81". Nos pasó en un entorno limpio. - «unexpected keyword argument 't3_model'». Tienes la versión de pip, que no trae V3. Instala desde el código del repo (arriba).
- Errores de CUDA con los ejemplos del README. Los ejemplos usan
device="cuda"; sin NVIDIA cámbialo a"cpu". - Falla la descarga de spacy_ontonotes.zip. Es un archivo que baja la primera vez. Si tu red lo bloquea, descárgalo con el navegador desde el enlace del error y descomprímelo en
~/.pkuseg/spacy_ontonotes.
6 Actualizar y desinstalar
✓ Probado por IACreadora en Linux sin GPU- Actualizar:
pip install -U chatterbox-tts(ogit pullsi lo instalaste desde el repo). - Desinstalar: borra el entorno (
.venv) y los modelos descargados en~/.cache/huggingface/hub/models--ResembleAI--chatterbox, que es lo que más pesa.
7 Licencia y uso comercial
Basado en la documentación oficialEl código y los modelos tienen licencia MIT, que permite uso comercial. Aun así: solo voces propias o con permiso, la marca de agua Perth va en cada audio y las redes piden etiquetar el contenido realista hecho con IA.
Ficha de Chatterbox: requisitos y licencia Repositorio en GitHub ↗
Preguntas frecuentes
¿Chatterbox es gratis?
Sí. Código y modelos con licencia MIT, gratis en tu PC y en la demo de Hugging Face (con cuota diaria de GPU).
¿Chatterbox habla español latino?
Sí. El modelo multilingüe incluye español y hay un modelo dedicado de español latino (es-MX/LatAm) con su propia demo.
¿Puedo usar Chatterbox sin tarjeta gráfica?
Sí, con device="cpu". En nuestra prueba, 5,6 s de audio tardaron 35 s con 8 núcleos.
¿Puedo clonar cualquier voz?
Técnicamente sí, pero solo debes clonar tu voz o una con permiso. Clonar a otra persona sin consentimiento puede ser ilegal y va contra las reglas de las redes.