Inicio › Open source › Voicebox › Cómo instalar
Cómo instalar Voicebox y generar voz clonada en español
Revisado el 29 oct 2026, versión 0.5.0 (probamos el código 0.6.0 del 7 oct 2026). Probado en Linux (Debian 13), 8 núcleos, 15 GB de RAM, sin GPU. Cada paso indica si lo probamos o si sale de la documentación oficial.
En Windows y Mac, baja el instalador de voicebox.sh. En Linux no hay instalador: usa Docker o instálalo desde el código (así lo probamos). Crea un perfil con unos segundos de tu voz, escribe el texto, elige español y un modelo como Qwen3-TTS, y genera. Sin GPU, 7,9 s de audio tardaron unos 35 s con la descarga del modelo. Clona solo tu voz o una con permiso.
0 Antes de empezar: voces con permiso
Basado en la documentación oficialUsa solo tu propia voz o una voz con permiso por escrito. Clonar la voz de otra persona sin su consentimiento puede ser ilegal y viola las reglas de TikTok, YouTube e Instagram. Si publicas voz generada que suena real, etiquétala como contenido hecho con IA.
En nuestra prueba no clonamos a nadie: la muestra fue una voz sintética que generamos con Chatterbox.
1 ¿Tu PC sirve?
Basado en la documentación oficial ✓ Probado por IACreadora en Linux sin GPU- Según el README: corre en Mac (MLX en Apple Silicon), Windows (CUDA o DirectML), Linux (CUDA o ROCm), Intel Arc y Docker. Sin GPU usa la CPU: «funciona en todas partes, solo más lento».
- Lo que medimos sin GPU: 8 núcleos y 15 GB de RAM; el proceso llegó a unos 5,3 GB de RAM.
- Disco: cada modelo pesa entre cientos de MB y varios GB. El Qwen3-TTS 0.6B bajó unos 2,5 GB.
2 Instalación en Windows y Mac
Basado en la documentación oficialNo lo probamos. Baja el instalador de voicebox.sh: DMG para Mac (Apple Silicon o Intel) y MSI para Windows. Todas las versiones están en los releases de GitHub (la última publicada es la 0.5.0, del 25 abr 2026). Según el README, en Windows con NVIDIA la app descarga sola los componentes de CUDA.
3 Instalación en Linux (desde el código)
✓ Probado por IACreadora en Linux sin GPU Basado en la documentación oficialEn Linux todavía no hay instalador. El README da dos caminos: docker compose up desde el repositorio, o compilarlo según voicebox.sh/linux-install. Probamos Docker, pero la imagen no se pudo construir en nuestra red; así que instalamos el servidor y la interfaz web desde el código (versión 0.6.0 del repositorio), con uv y Bun:
git clone https://github.com/jamiepine/voicebox.git && cd voicebox
uv venv -p 3.12 .venv && . .venv/bin/activate
uv pip install --index-url https://download.pytorch.org/whl/cpu torch torchaudio
uv pip install -r backend/requirements.txt --extra-index-url https://download.pytorch.org/whl/cpu --index-strategy unsafe-best-match
uv pip install --no-deps chatterbox-tts hume-tada omnivoice
uv pip install git+https://github.com/QwenLM/Qwen3-TTS.git
bun install && cd web && bunx --bun vite build && cp -r dist ../frontend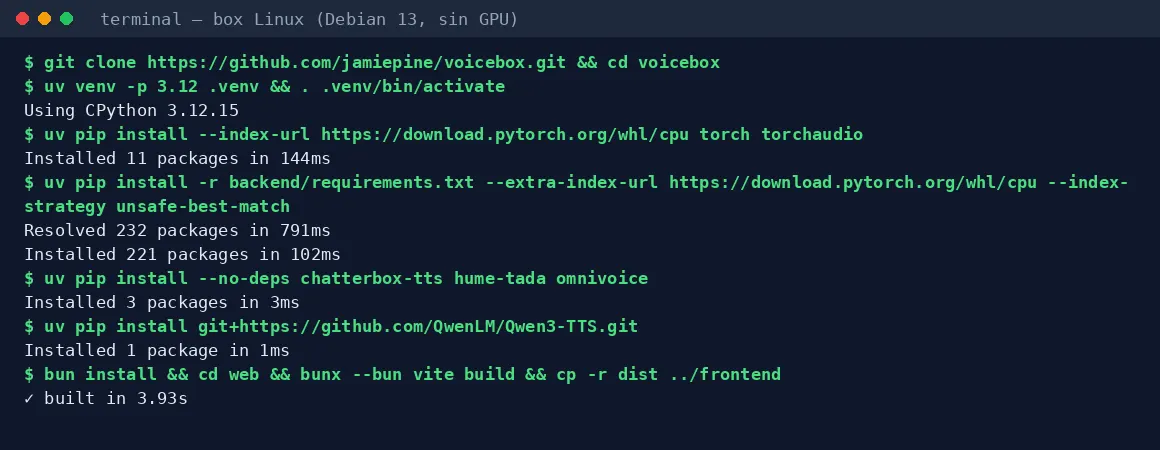
Las líneas de PyTorch para CPU y el --no-deps fueron nuestros ajustes para una máquina sin NVIDIA; con GPU sigue las instrucciones oficiales.
4 Arranca el servidor
✓ Probado por IACreadora en Linux sin GPUDesde la carpeta del repositorio, con el entorno activado:
uvicorn backend.main:app --port 17600
# luego abre http://localhost:17600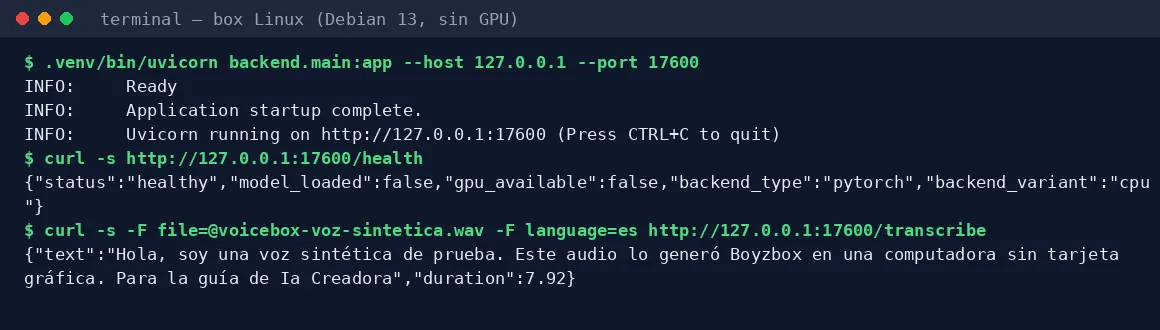
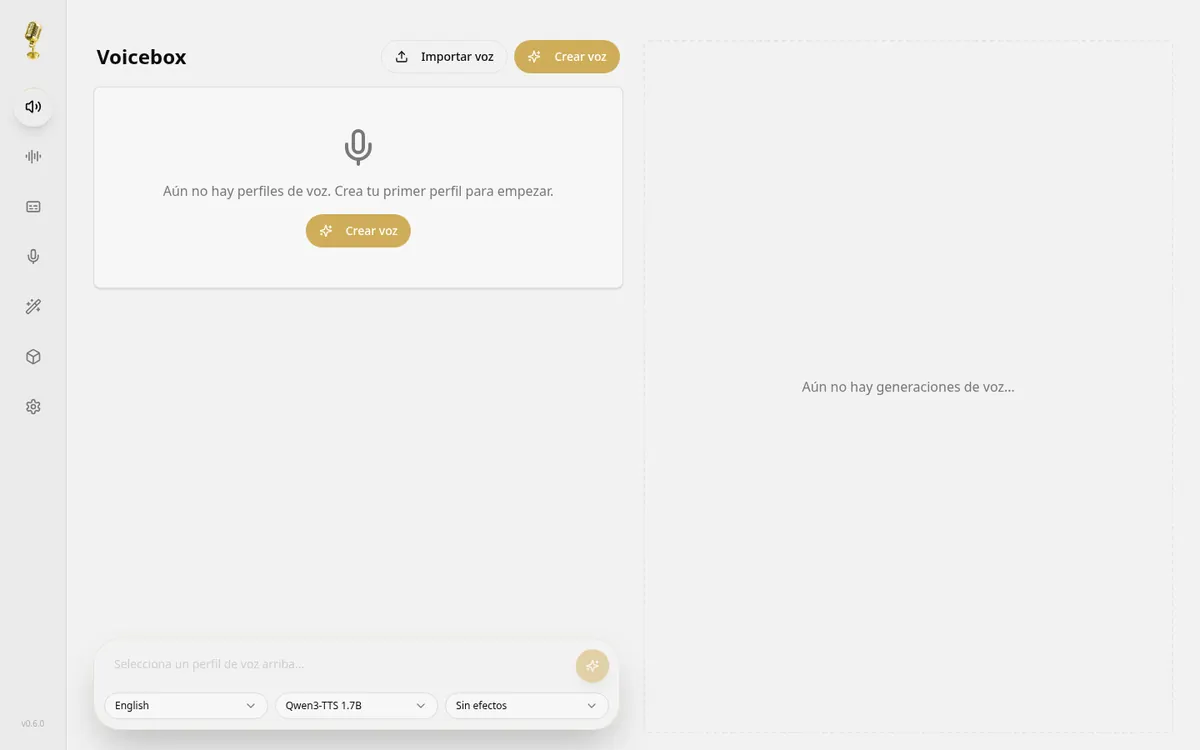
La app de escritorio usa el puerto 17493 para su API y su servidor MCP, según el README; nosotros elegimos 17600.
5 Crea un perfil de voz
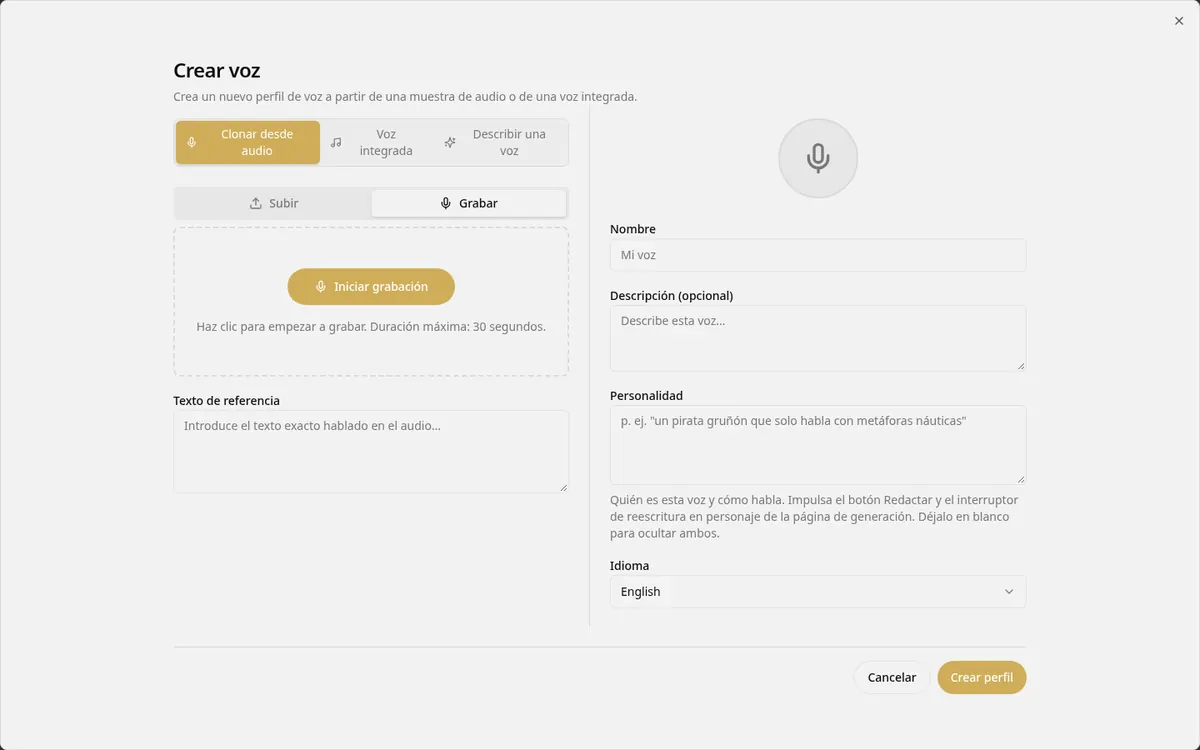
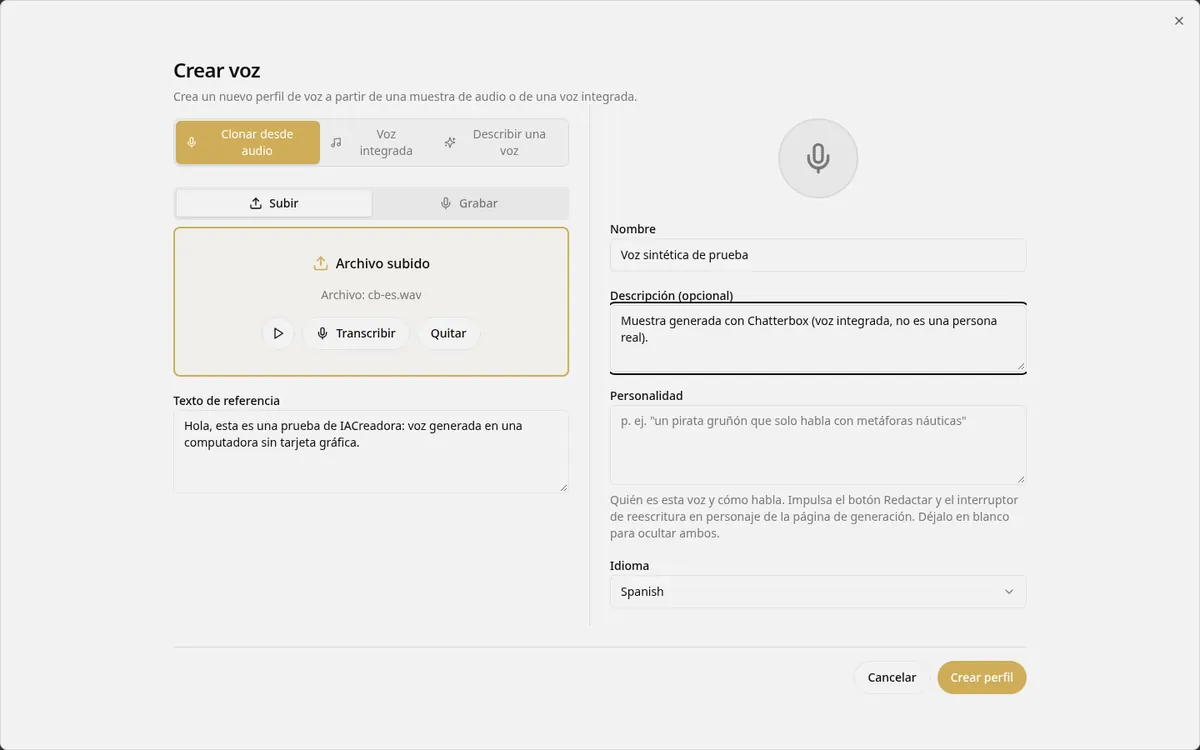
✓ Probado por IACreadora en Linux sin GPUPulsa «Crear voz», elige clonar desde un audio, sube la muestra y escribe lo que dice. Usamos 5,6 s de una voz sintética:
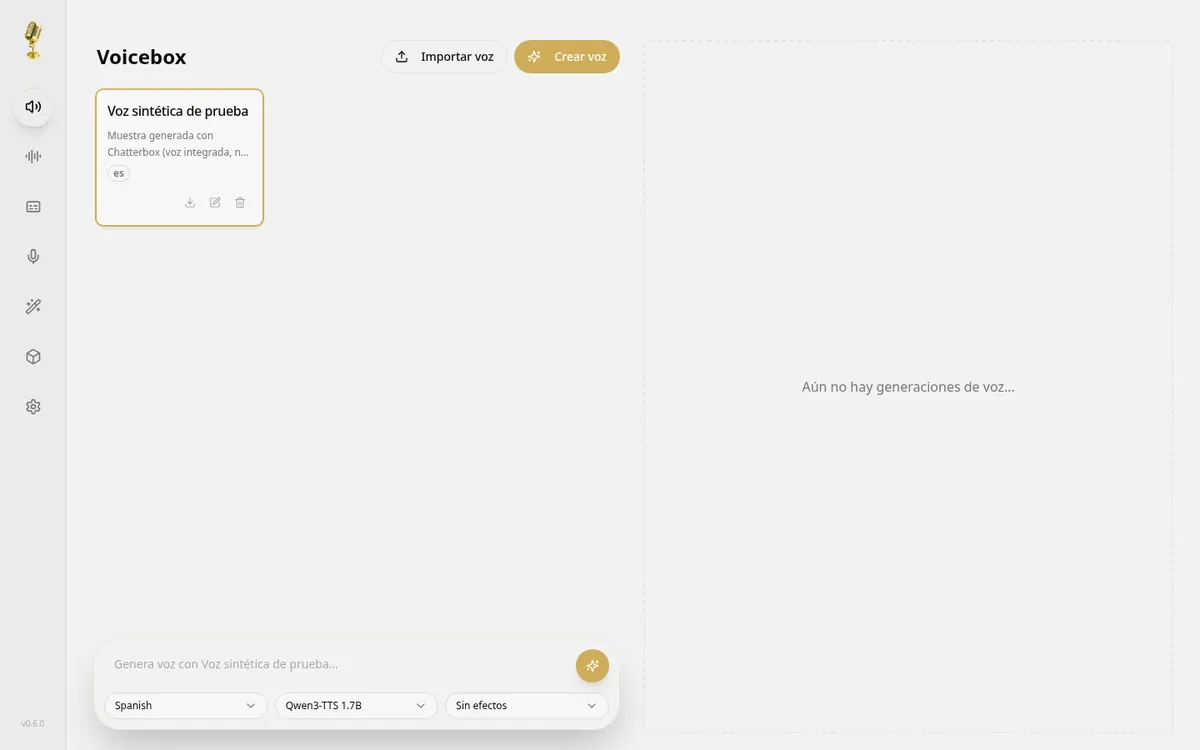
6 Genera voz en español
✓ Probado por IACreadora en Linux sin GPUEscribe el texto, elige el idioma y el modelo. La primera vez descarga el modelo:
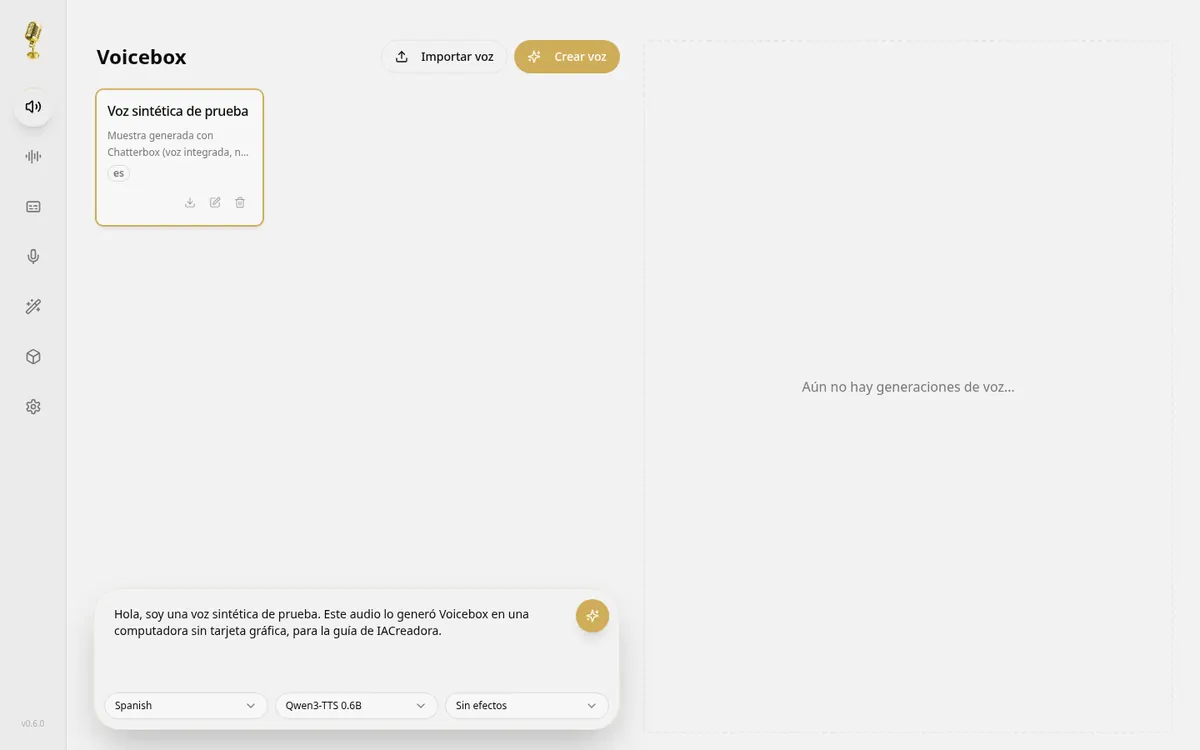
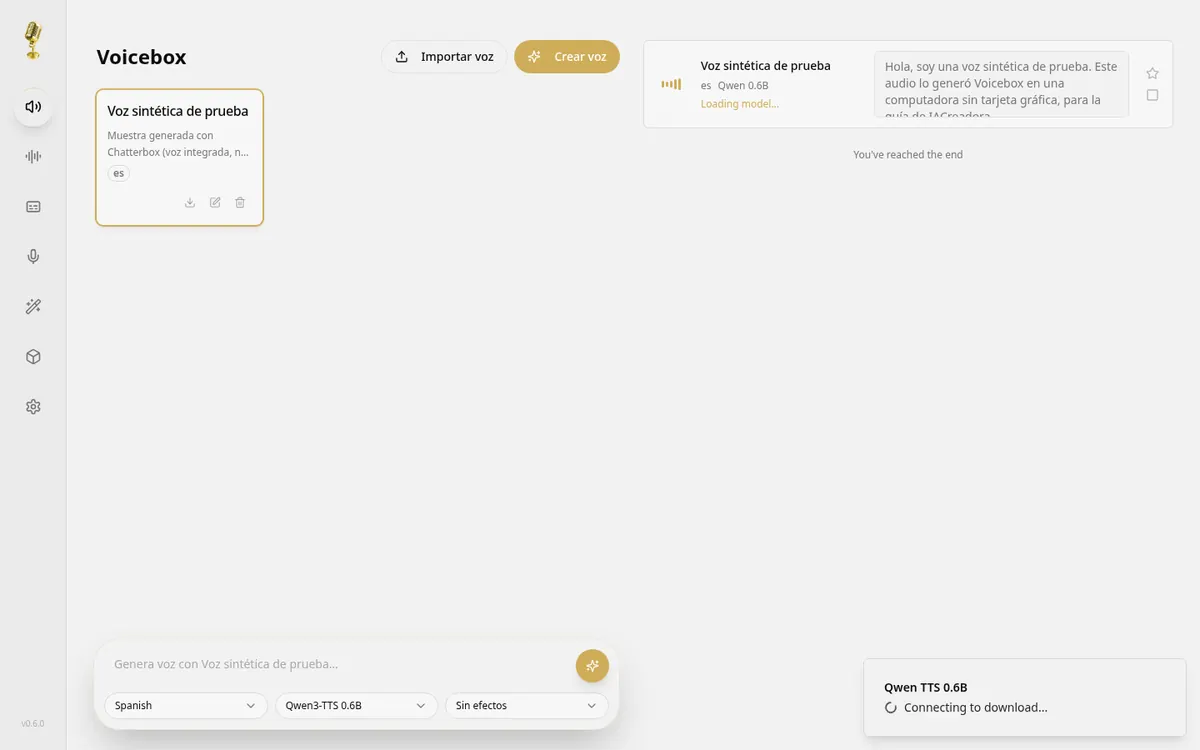
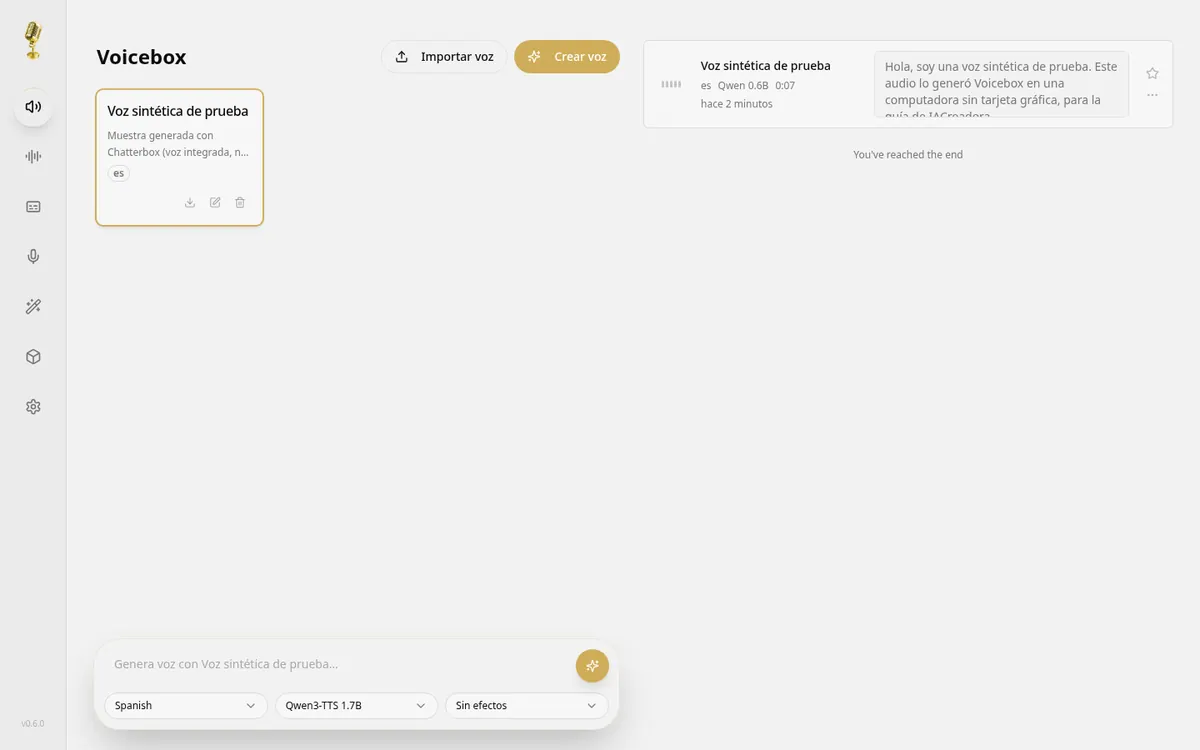
Este es el audio que salió:
7 Qué modelo elegir
✓ Probado por IACreadora en Linux sin GPU Basado en la documentación oficial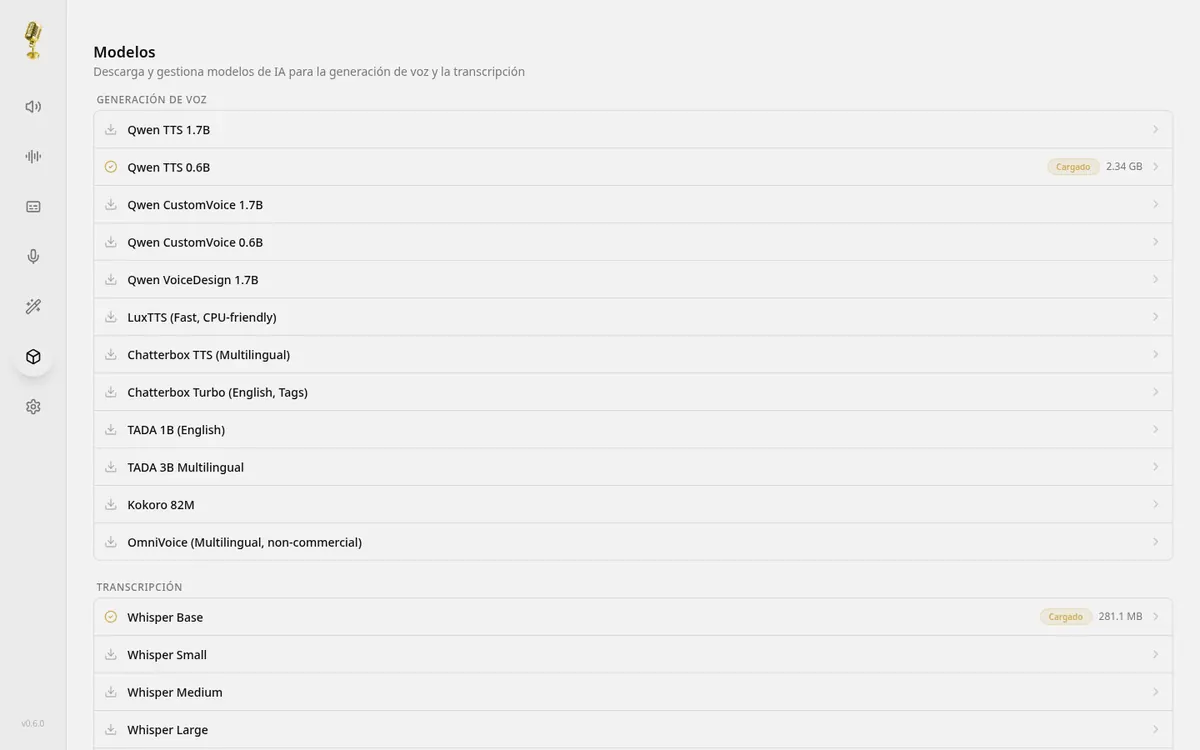
- Qwen3-TTS (0.6B y 1.7B): clona en 10 idiomas, incluido español. Probamos el 0.6B.
- Chatterbox Multilingual: 23 idiomas, incluido español.
- LuxTTS y Chatterbox Turbo: solo inglés.
- OmniVoice: la app lo marca como no comercial.
Fuera del Qwen3-TTS 0.6B, no probamos ninguno.
8 Lo que no probamos
Basado en la documentación oficialSegún el README, Voicebox también dicta texto con un atajo global, aplica efectos de audio, edita en una línea de tiempo y tiene una API REST y un servidor MCP para que agentes de IA usen tu voz. Nada de eso lo probamos, ni los instaladores de Windows y Mac ni una GPU.
9 Licencia y uso comercial
Basado en la documentación oficialLa app tiene licencia MIT: puedes usarla gratis, también para trabajo comercial. Cada modelo de voz tiene su propia licencia: revisa la del que uses antes de monetizar (la app marca OmniVoice como no comercial). Y recuerda el paso 0: solo tu voz o una con permiso.
Ficha de Voicebox: requisitos y licencia Repositorio en GitHub ↗
Preguntas frecuentes
¿Voicebox es gratis?
Sí. Es código abierto (MIT), sin suscripción ni cobro por caracteres. Los modelos se descargan gratis, pero pesan varios GB.
¿Voicebox habla español?
Sí. Lo probamos con Qwen3-TTS 0.6B en español: se entiende bien, aunque el acento no es latino. Chatterbox Multilingual también tiene español.
¿Voicebox necesita tarjeta gráfica?
No. Lo probamos solo con CPU: 7,9 s de audio en unos 35 s, contando la primera descarga del modelo, con unos 5,3 GB de RAM.
¿Voicebox funciona en Linux?
Sí, pero sin instalador: con Docker o desde el código. Nosotros lo instalamos desde el código en Debian.