Estudio de voz con IA que corre en tu PC, alternativa gratis a ElevenLabs: clona una voz con unos segundos de audio, genera voz en español con varios modelos (Qwen3-TTS, Chatterbox, Kokoro…), aplica efectos y tiene API local.
¿Es gratis?
El software, sí. Es código abierto con licencia MIT: lo descargas y lo usas sin pagar licencia ni suscripción. Ojo con la licencia del modelo: La app es MIT, que permite uso comercial. Lo que generas depende del modelo que elijas: la propia app marca OmniVoice como no comercial, así que revisa la licencia de cada motor. Y clona solo tu voz o una con permiso por escrito. Lo que puede costarte:
Nada: no tiene suscripción ni cobra por minuto.
Los modelos se descargan gratis, pero pesan: el Qwen3-TTS más liviano bajó unos 2,5 GB en nuestra prueba.
Estrellas en GitHub
★ 59.266 al 2 nov 2026 Miden popularidad en GitHub, no calidad ni si te sirve. Mismo corte para todas las herramientas.
Licencia
MIT · Uso comercial: Sí, el programa; lo generado depende del modelo La app es MIT, que permite uso comercial. Lo que generas depende del modelo que elijas: la propia app marca OmniVoice como no comercial, así que revisa la licencia de cada motor. Y clona solo tu voz o una con permiso por escrito.
Requisitos
GPU opcional Windows, Mac o Linux; Python 3.12 si lo instalas desde el código. Aprovecha NVIDIA (CUDA), AMD (ROCm), Intel Arc, DirectML en Windows y Apple Silicon (MLX), y si no hay GPU usa la CPU. Sin GPU, en nuestra prueba: 7,9 s de voz en unos 35 s con Qwen3-TTS 0.6B, contando la primera descarga del modelo (unos 2,5 GB). El proceso llegó a unos 5,3 GB de RAM.
Probar sin instalar
No tiene versión web ni nube: se instala en tu equipo
Dificultad
Media: En Windows y Mac es un instalador normal. En Linux no hay instalador: se usa Docker o se instala desde el código (así lo probamos).
Sistemas
Windows, Mac, Linux
En español
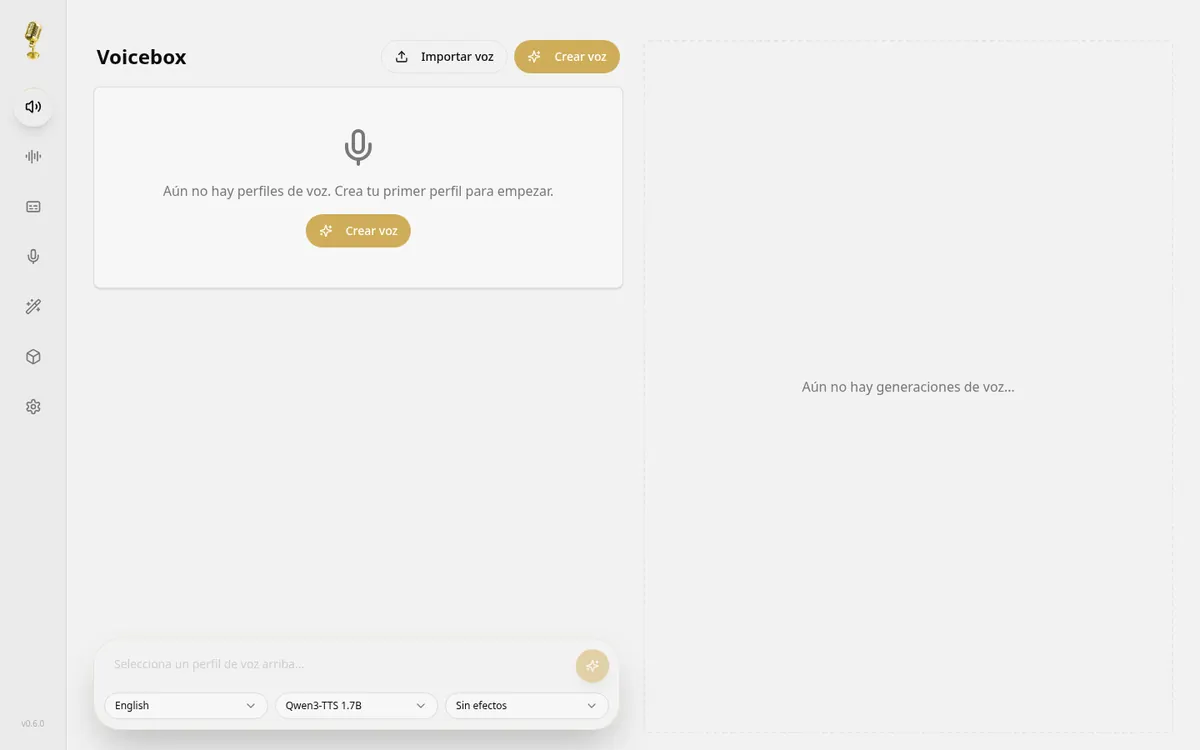
La interfaz salió en español en nuestra prueba y genera voz en español (Qwen3-TTS, Chatterbox y otros motores lo incluyen).
Versión revisada
0.5.0 (probamos el código 0.6.0 del 7 oct 2026) (publicada el 25 abr 2026)
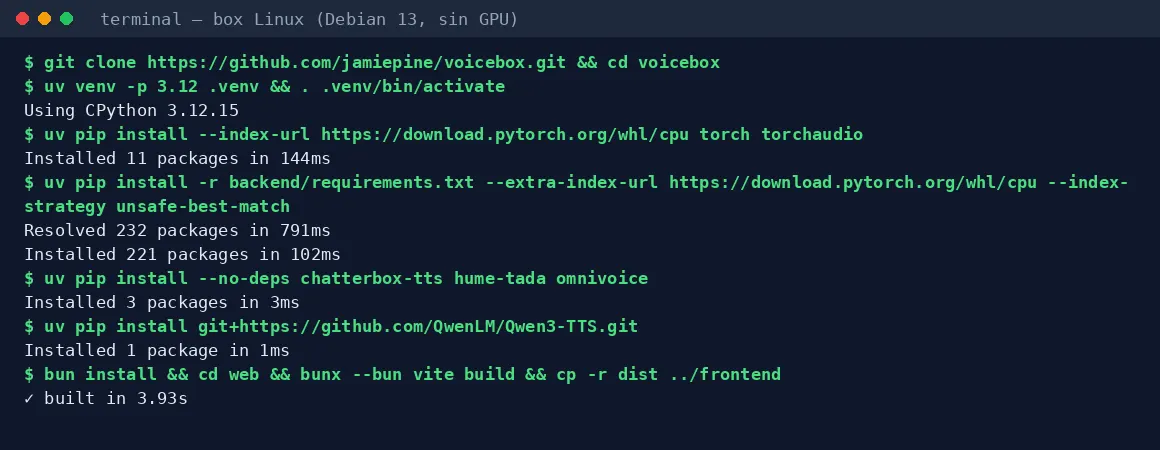
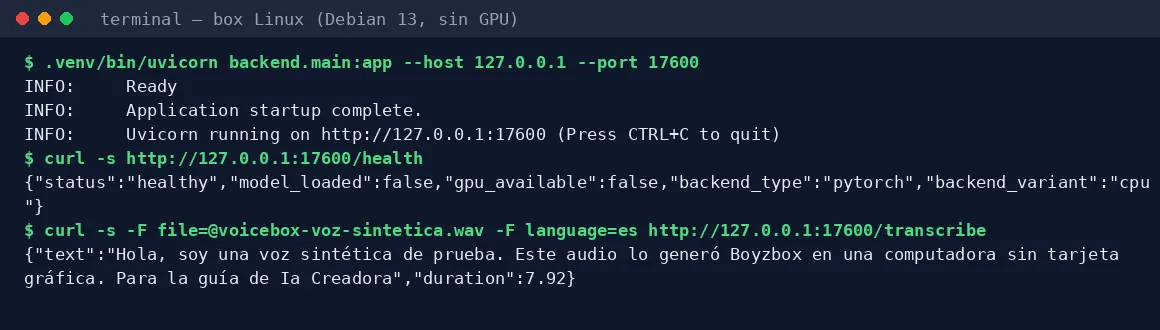
En Linux no hay instalador y la imagen de Docker no se pudo construir en nuestra red, así que lo instalamos desde el código. Creamos un perfil con una voz sintética (no de una persona real), generamos 7,9 s de voz en español con Qwen3-TTS 0.6B en CPU y comprobamos el audio con su propio Whisper. No probamos los instaladores de Windows y Mac ni una GPU.
Equipo: Linux (Debian 13), 8 núcleos, 15 GB de RAM, sin GPU · Voicebox 0.6.0 desde el código (commit 8af7efe), PyTorch para CPU · 29 oct 2026
Nuestra instalación de Voicebox desde el código (Linux sin GPU), 29 oct 2026.
Estrellas y versión de la API de GitHub; requisitos del README oficial. ¿Ves un dato incorrecto? Avísanos.
✓ Probado por IACreadora el 29 oct 2026 en Linux sin GPU
Resultado de nuestra prueba
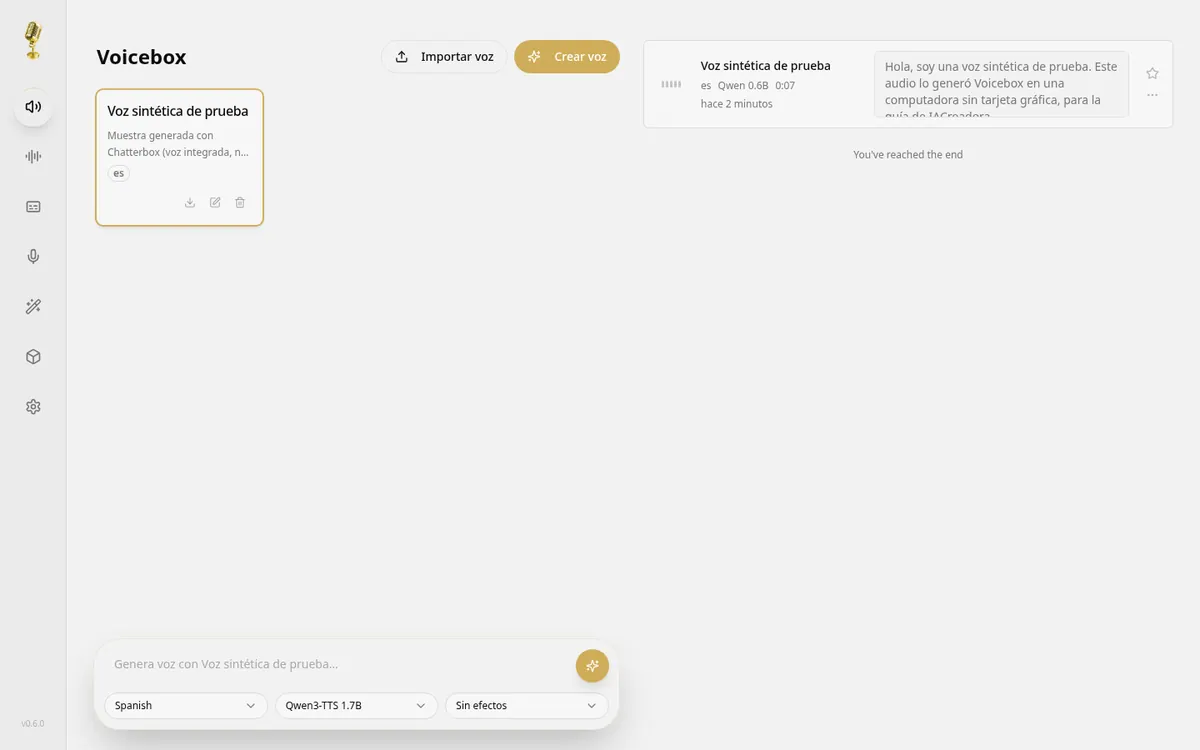
La voz clonada que generó Voicebox en nuestra prueba, usando solo el procesador.
Este es el audio tal como lo generó Voicebox en nuestra computadora, sin GPU (lo pasamos de WAV a MP3 para la web):
Texto que le dimos
«Hola, soy una voz sintética de prueba. Este audio lo generó Voicebox en una computadora sin tarjeta gráfica, para la guía de IACreadora.»
Voz: clonada de una muestra de 5,6 s que hicimos con Chatterbox (su voz por defecto, no la de una persona real).
Modelo: Qwen3-TTS 0.6B, idioma español.
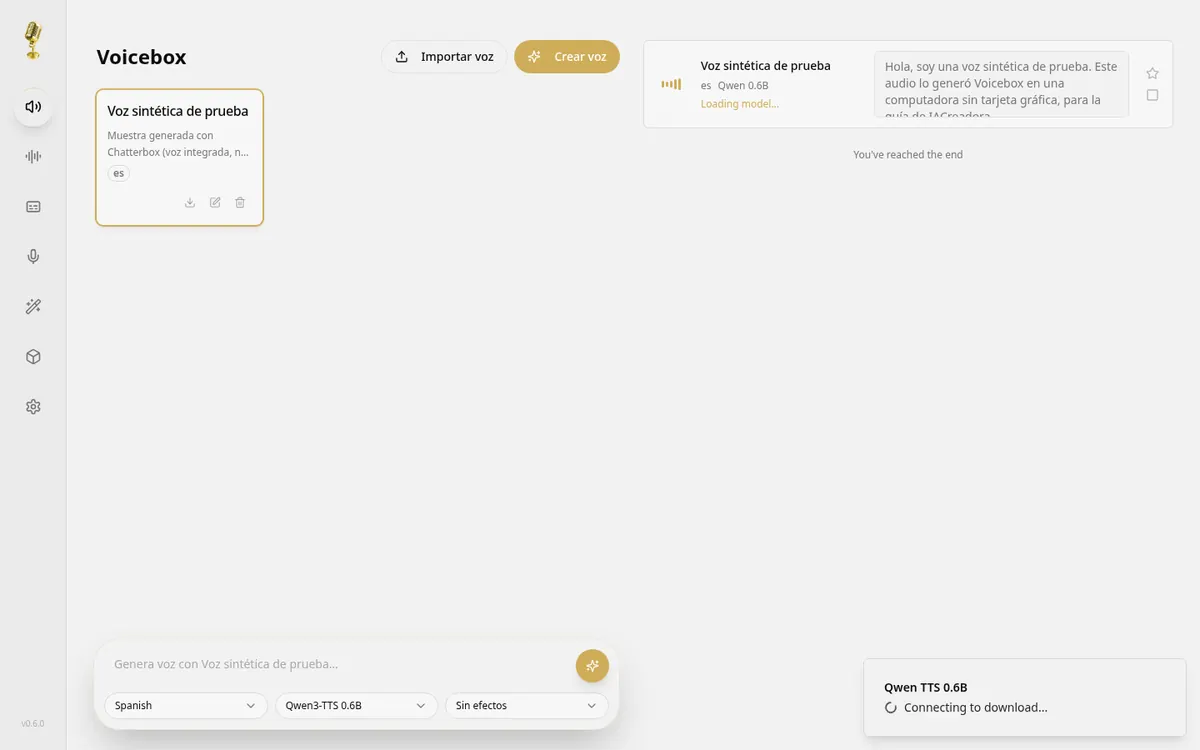
Tiempo: unos 35 s para 7,9 s de audio, contando la primera descarga del modelo (1,8 GB más 0,7 GB). 8 núcleos, sin GPU; el proceso llegó a unos 5,3 GB de RAM.
Comprobación: la transcripción con Whisper (dentro de Voicebox) devolvió «…lo generó Boyzbox en una computadora sin tarjeta gráfica. Para la guía de Ia Creadora».
Se entiende bien, pero el acento no es latino y los nombres propios se deforman: Whisper oyó «Boyzbox» en vez de «Voicebox». Cada generación sale un poco distinta.
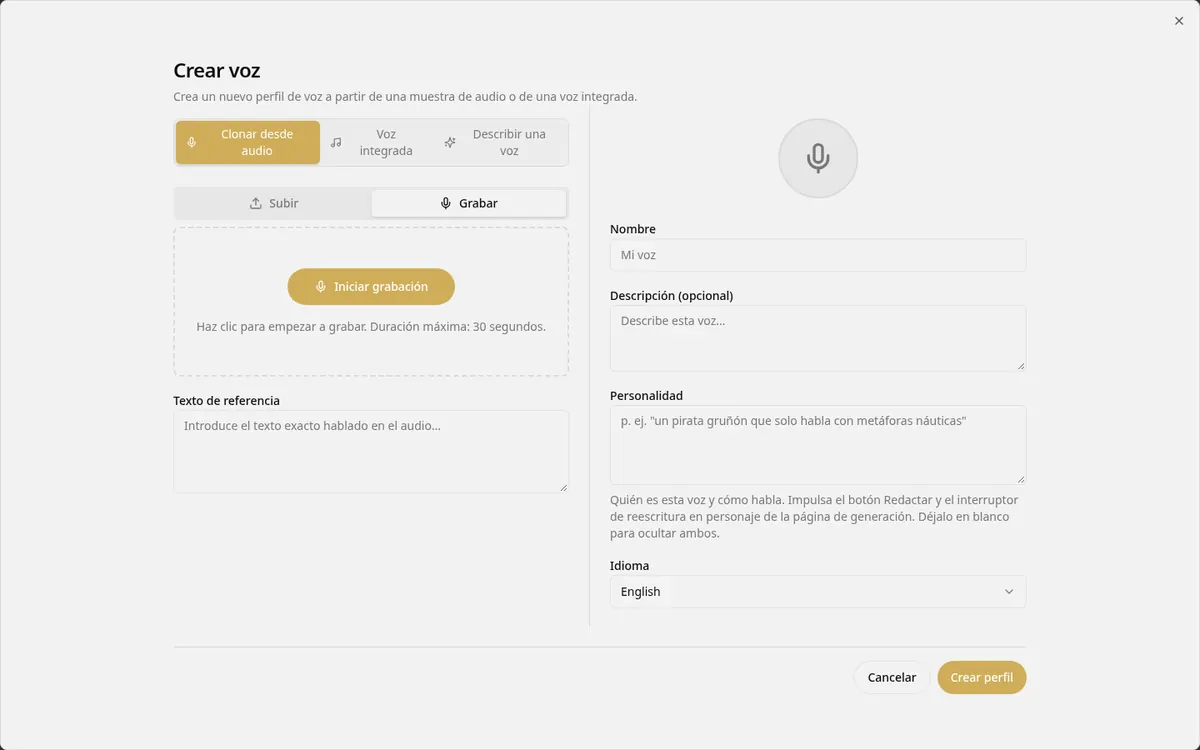
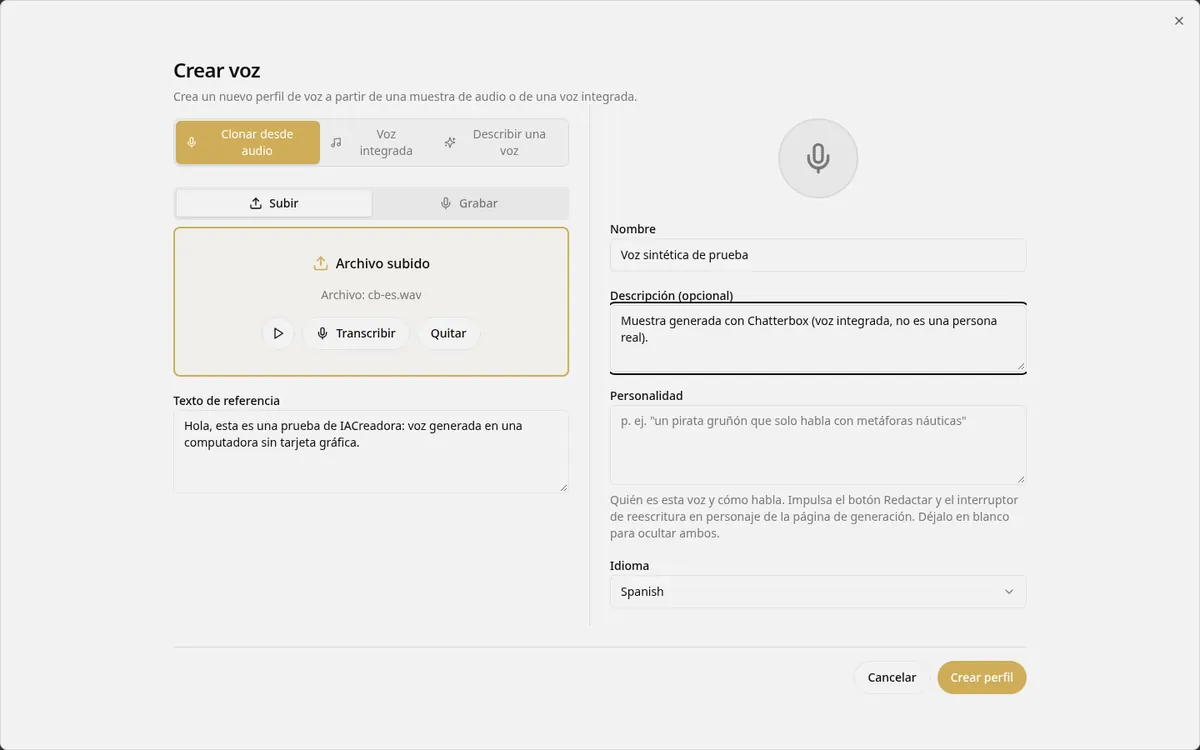
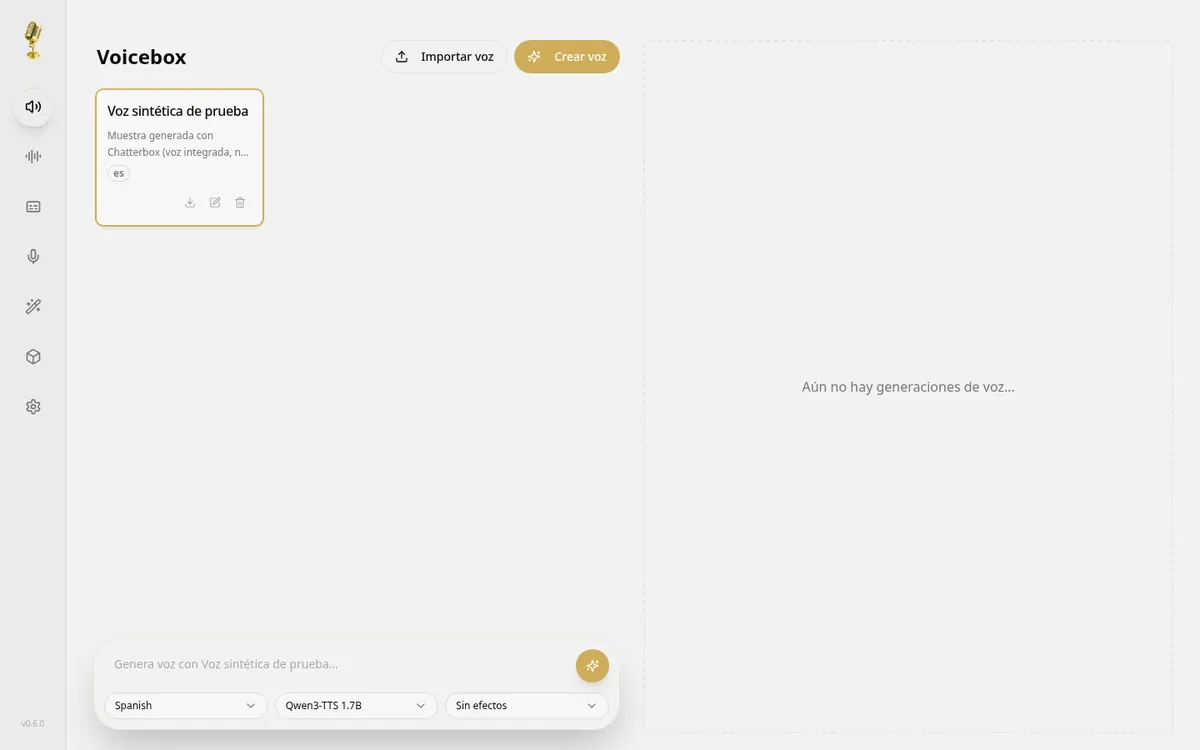
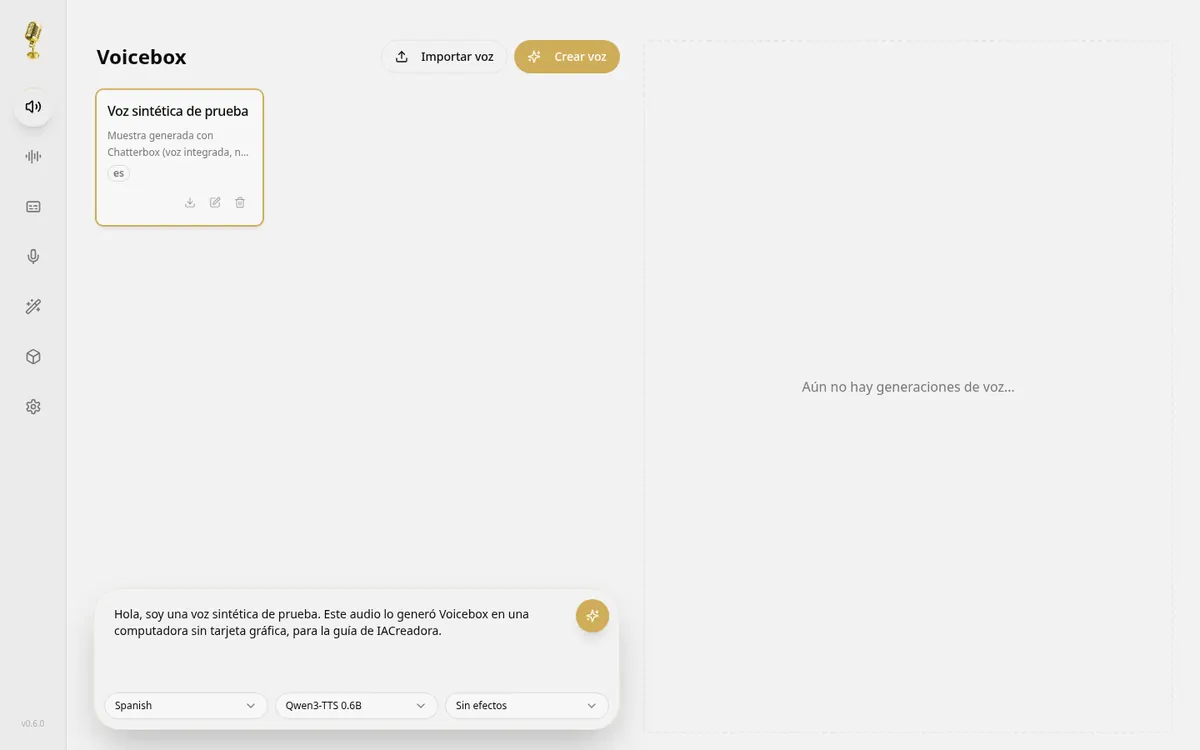
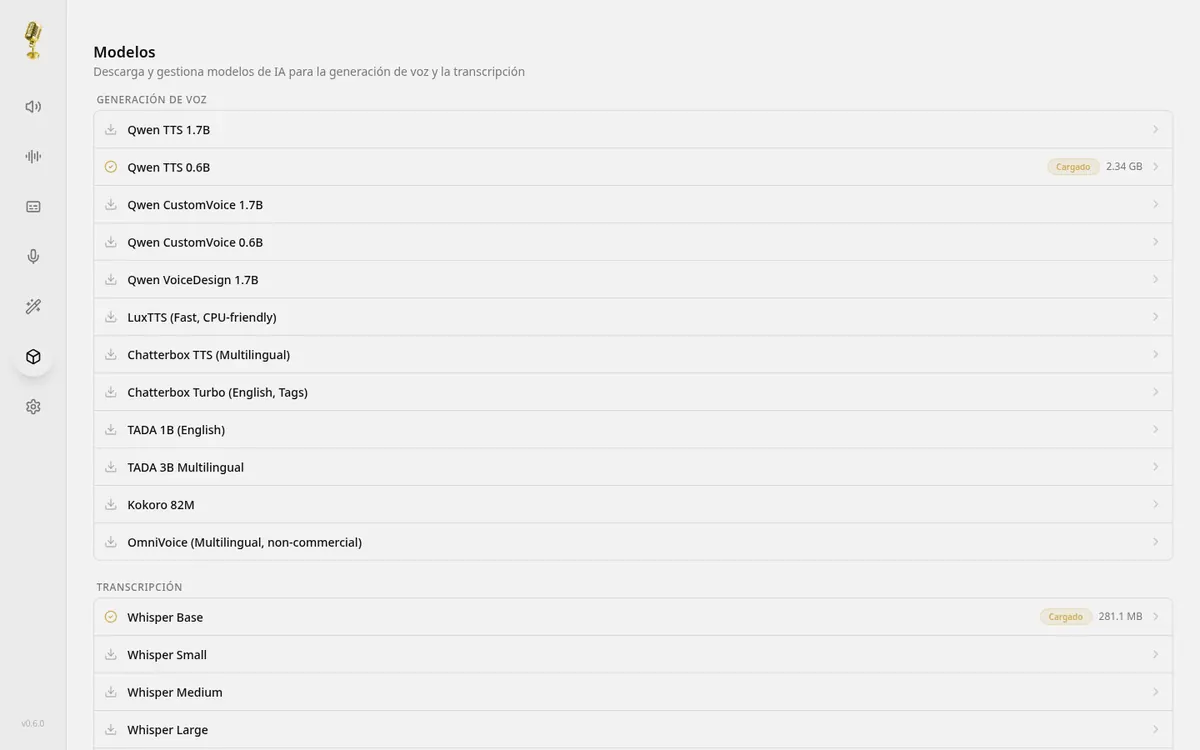
Capturas reales de cada paso, del 29 oct 2026. La guía de instalación las explica una por una.
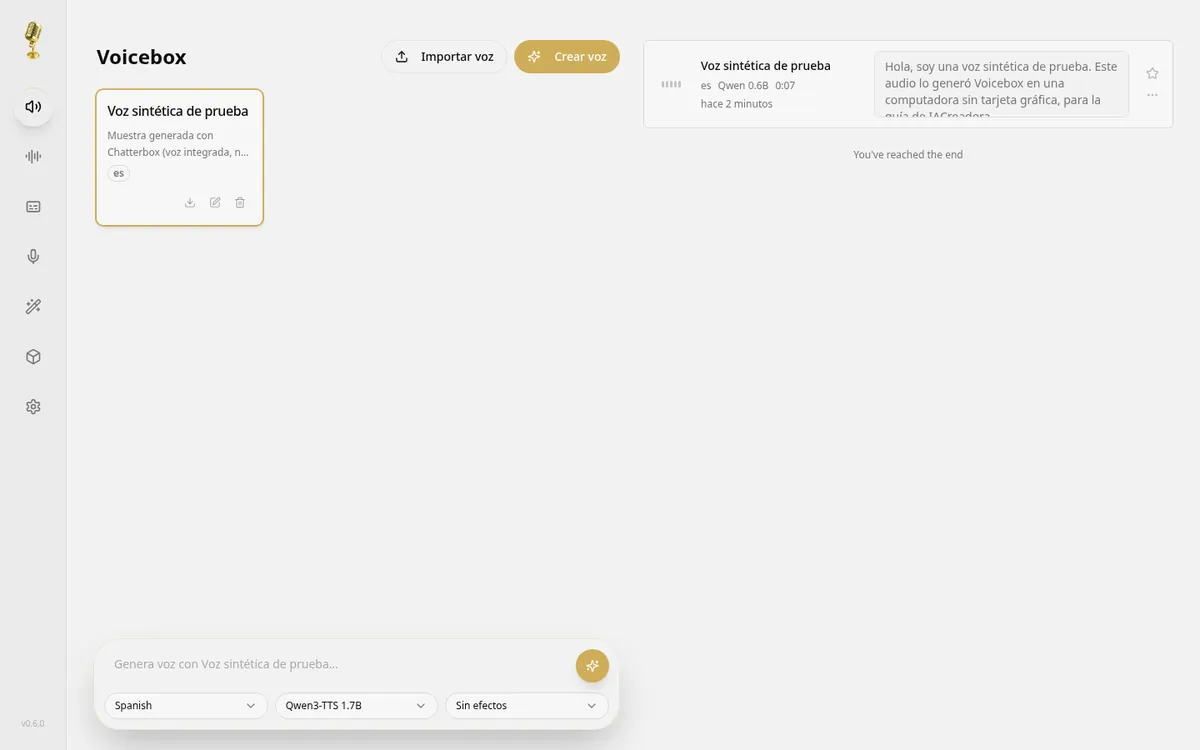
Captura 1. Instalación desde el código en Linux: entorno de Python 3.12 con uv, PyTorch para CPU, dependencias del backend y la interfaz web compilada con Bun.Captura 2. Arrancamos el servidor y comprobamos su estado: sin GPU, PyTorch en modo CPU.Captura 3. La interfaz web de Voicebox, en español y sin voces todavía.Captura 4. «Crear voz»: clonar desde un audio, usar una voz integrada o describir una voz con texto.Captura 5. Subimos la muestra de referencia: 5,6 s de una voz sintética generada con Chatterbox (no es una persona real) y su texto.Captura 6. Perfil creado: «Voz sintética de prueba», en español.Captura 7. Escribimos el texto, elegimos español y el modelo Qwen3-TTS 0.6B, el más liviano de los que clonan en español.Captura 8. La primera vez descarga el modelo (1,8 GB más 0,7 GB del tokenizador de voz) y lo carga.Captura 9. Audio listo: 7,9 s. Todo el proceso, con la descarga, tomó unos 35 s en CPU.Captura 10. Pantalla de modelos: Qwen3-TTS, Chatterbox, Kokoro, LuxTTS, TADA y otros, cada uno con su tamaño.
ElevenLabs suena más natural, tiene más voces y doblaje en la nube. Voicebox es gratis y corre en tu PC: clona y genera voz en español sin pagar por caracteres y sin subir tus audios.
ElevenLabs: Desde US$6/mes (Starter), facturación mensual · revisado el 14 oct 2026
Fish Audio clona voces en la nube con planes de pago. Voicebox hace clonación y texto a voz en tu equipo, con varios modelos para elegir y licencia MIT.
Fish Audio: Desde US$11/mes (Plus), facturación anual (US$132/año); US$15/mes si se paga mes a mes · revisado el 22 oct 2026
Murf AI es un estudio de voz en la nube con voces listas y editor de proyectos. Voicebox es gratis y local; tiene historial y efectos, pero tú instalas y descargas los modelos.
Murf AI: Desde US$19/mes, facturación anual; US$29/mes si se paga mes a mes · revisado el 14 oct 2026
Preguntas frecuentes
¿Voicebox es gratis?
Sí: el programa es de código abierto (MIT) y no pagas licencia para uso personal; el uso comercial tiene condiciones (ver licencia). Lo que puede costar: Nada: no tiene suscripción ni cobra por minuto. Los modelos se descargan gratis, pero pesan: el Qwen3-TTS más liviano bajó unos 2,5 GB en nuestra prueba.
¿Voicebox necesita tarjeta gráfica?
GPU opcional (sin ella va más lento). Windows, Mac o Linux; Python 3.12 si lo instalas desde el código. Aprovecha NVIDIA (CUDA), AMD (ROCm), Intel Arc, DirectML en Windows y Apple Silicon (MLX), y si no hay GPU usa la CPU. Sin GPU, en nuestra prueba: 7,9 s de voz en unos 35 s con Qwen3-TTS 0.6B, contando la primera descarga del modelo (unos 2,5 GB). El proceso llegó a unos 5,3 GB de RAM.
¿Se puede probar Voicebox sin instalar?
No tiene versión web ni nube: se instala en tu equipo.
¿Puedo usar Voicebox para contenido comercial?
La app es MIT, que permite uso comercial. Lo que generas depende del modelo que elijas: la propia app marca OmniVoice como no comercial, así que revisa la licencia de cada motor. Y clona solo tu voz o una con permiso por escrito.
Las mejores herramientas de IA gratis para creadores
PDF de 10 páginas con las 42 herramientas de nuestro directorio que tienen plan gratis permanente (qué incluye gratis, precio en US$ con su equivalente en pesos y si funcionan en español) y las 10 herramientas open source que instalamos y probamos.
Sin spam. Puedes darte de baja cuando quieras. Privacidad.
 De pago / freemium
 MoneyPrinterTurbo
 ComfyUI
 Buzz
 Chatterbox
 OpenCut
 Concat
 KittenTTS
 Postiz
 Cap